
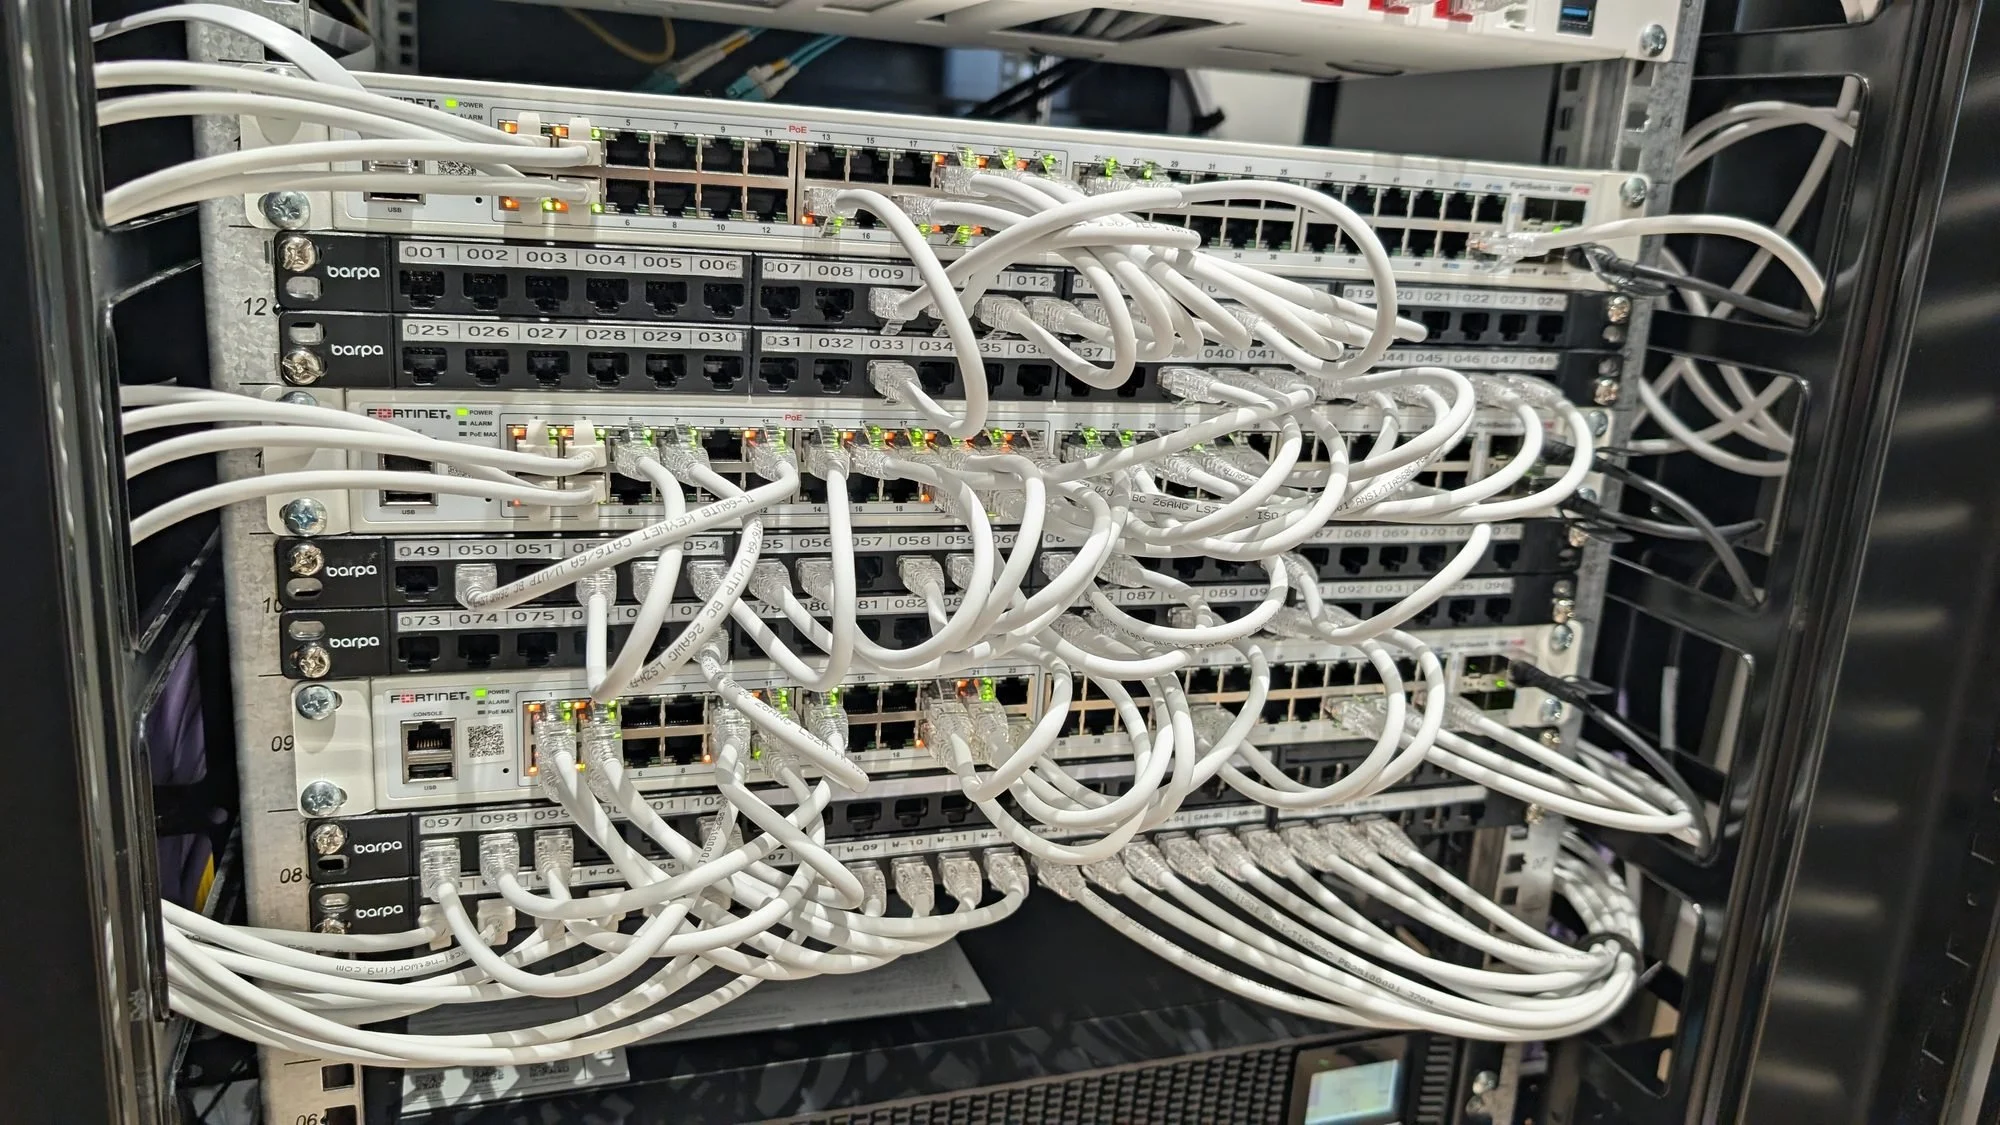
Un tall de connectivitat intermitent és una de les incidències més costoses de resoldre en una xarxa empresarial: quan el tècnic arriba, el servei sol haver-se restablert i no queda cap evidència del que va passar. El resultat habitual és el reinici preventiu d’equips o una reclamació a l’operador, sense haver identificat la causa arrel.
Aquesta guia descriu la metodologia que apliquem per acotar un tall per capes, i les set causes que trobem més sovint en infraestructures d’oficina: des de l’enllaç WAN fins a l’alimentació elèctrica de l’electrònica de xarxa.
Causes analitzades
- Caiguda o inestabilitat de l’enllaç WAN.
- Fallades de resolució DNS.
- Esgotament de l’àmbit DHCP i conflictes d’adreçament.
- Bucles de capa 2 i tempestes de broadcast.
- Saturació de recursos al firewall perimetral.
- Microtalls elèctrics i reinicis de l’electrònica.
- Desconnexions limitades a la xarxa sense fil.
Pas previ: caracteritzar el tall
La informació més valuosa s’obté durant el mateix tall, no després. Abans de reiniciar cap equip convé respondre quatre preguntes, que per si soles descarten la majoria d’hipòtesis:
- Abast: afecta tota l’oficina, una planta, un switch concret o usuaris aïllats? Afecta igual els equips amb cable i els sense fil?
- Serveis: es perd només l’accés a internet o també els recursos interns (servidors de fitxers, impressores, telefonia IP)?
- Nom davant d’IP: respon una destinació externa per adreça IP (per exemple, un ping a un resolutor públic) encara que les webs no carreguin per nom?
- Patró temporal: hora exacta d’inici i de fi, durada i si es repeteix en franges concretes. Correlacionar-ho després amb els registres de firewall, switches i controlador és el que permet tancar la diagnosi.
Com a regla general: si també es perden els recursos interns, el problema és a la LAN (causes 3, 4 i 6); si la LAN funciona i falla internet, a la WAN, el DNS o el firewall (causes 1, 2 i 5); si només afecta usuaris sense fil, a la xarxa wifi (causa 7).
1. Caiguda o inestabilitat de l’enllaç WAN
És la causa més evident, però no sempre es manifesta com una caiguda completa. Els microtalls de pocs segons, la pèrdua de sincronisme a l’ONT o al router de l’operador i els episodis de pèrdua de paquets o latència elevada a la xarxa de l’operador provoquen desconnexions de VPN, talls en videoconferències i sessions d’aplicacions al núvol que es tanquen, sense que l’enllaç arribi a figurar com a caigut.
Diagnosi: revisar al firewall o al router el registre d’esdeveniments de la interfície WAN (canvis d’estat, renegociacions, renovacions de sessió PPPoE o DHCP) i establir un monitoratge ICMP continu tant contra la porta d’enllaç de l’operador com contra destinacions externes. Si la pèrdua apareix ja al primer salt, el problema és a l’accés; si només apareix més enllà, a la xarxa de l’operador. La mitigació estructural és un segon enllaç d’un altre operador, amb commutació automàtica o SD-WAN.
2. Fallades de resolució DNS
Des del punt de vista de l’usuari, una fallada de DNS és indistingible d’un tall d’internet: no carrega res. Les causes típiques són un únic servidor DNS intern sense redundància (sovint el controlador de domini), reenviadors configurats cap a resolutors lents o inestables, o clients que reben per DHCP un DNS que ja no existeix. En entorns amb Active Directory, una fallada de DNS intern afecta, a més, l’autenticació i l’accés a recursos compartits.
Diagnosi: durant l’incident, comprovar si hi ha connectivitat per IP i no per nom. Llançar consultes amb nslookup o dig contra el DNS configurat al client, contra el DNS intern i contra un resolutor públic, comparant resultats i temps de resposta. La configuració correcta inclou almenys dos servidors DNS interns, reenviadors redundants i un DHCP que lliuri tots dos.
3. Esgotament de l’àmbit DHCP i conflictes d’adreçament
Quan l’àmbit DHCP s’esgota, els dispositius nous no obtenen adreça i es queden sense connectivitat, mentre la resta de l’oficina funciona amb normalitat. És habitual en xarxes on convidats, mòbils i IoT comparteixen segment amb els equips corporatius, amb temps de concessió llargs. Els conflictes d’IP, per la seva banda, apareixen quan s’assignen adreces estàtiques dins del rang dinàmic, i produeixen talls intermitents difícils de reproduir.
Diagnosi: un client amb adreça autoassignada (169.254.x.x) indica que no ha obtingut concessió. Revisar l’ocupació de l’àmbit, el temps de concessió i l’existència d’estàtiques dins del rang, i consultar al servidor DHCP o al switch els registres de conflicte. La solució passa per segmentar en VLAN amb àmbits dimensionats, separar els convidats amb concessions curtes i documentar les reserves.
4. Bucles de capa 2 i tempestes de broadcast
Un latiguillo que connecta dues preses de la mateixa xarxa, un switch no gestionat sota una taula o un equip de videoconferència amb dues interfícies pontejades n’hi ha prou per crear un bucle. Sense protecció, el trànsit de broadcast es multiplica fins a saturar els enllaços i la CPU dels switches, i tota la xarxa deixa de respondre de manera intermitent. És una de les causes que més temps costa identificar si no se’n coneix el símptoma.
Diagnosi: caigudes generalitzades de la LAN, activitat contínua a tots els ports i CPU dels switches elevada són indicatius d’un bucle. Revisar els registres de canvis de topologia d’spanning tree, els missatges de MAC flapping i els comptadors de broadcast per port. La prevenció és configuració: RSTP o MSTP correctament desplegat, BPDU guard als ports d’usuari, storm control i l’eliminació de switches no gestionats a l’accés.
5. Saturació de recursos al firewall perimetral
Un firewall infradimensionat o amb totes les funcions d’inspecció actives pot esgotar la CPU, la memòria o la taula de sessions en hores punta. El símptoma és característic: les connexions ja establertes continuen funcionant mentre les noves fallen o triguen a obrir-se, o la latència augmenta de manera brusca. El creixement de la plantilla, l’adopció d’aplicacions al núvol o un equip infectat que genera connexions massives ho poden desencadenar.
Diagnosi: consultar l’històric de CPU, memòria i nombre de sessions concurrents del firewall i comparar-lo amb les especificacions del model per a les funcions de seguretat actives, no amb el throughput màxim de catàleg. Identificar els hosts amb més sessions obertes. Si l’equip opera de manera sostinguda a prop del seu límit, cal ajustar les polítiques d’inspecció o redimensionar.
6. Microtalls elèctrics i reinicis de l’electrònica
Un microtall de subministrament d’una fracció de segon pot passar desapercebut per a la il·luminació i, tanmateix, reiniciar un switch, el firewall o l’ONT de l’operador. El tall resultant dura el que triga l’equip a arrencar, diversos minuts en molts casos, i se sol atribuir a l’operador. Les fonts d’alimentació degradades i els problemes tèrmics en racks sense ventilació produeixen símptomes equivalents.
Diagnosi: comprovar l’uptime de cada equip de xarxa: si algun s’ha reiniciat coincidint amb el tall, la causa és d’alimentació o de maquinari, no de xarxa. Revisar els registres d’arrencada i les alarmes de temperatura i de font d’alimentació. Tota l’electrònica crítica, inclosa l’ONT de l’operador, ha d’estar protegida per un SAI amb una autonomia coneguda i verificada periòdicament.
7. Desconnexions limitades a la xarxa sense fil
Si els equips amb cable mantenen la connectivitat i només la perden els sense fil, el domini del problema és la xarxa wifi. Les causes habituals són fallades d’autenticació contra el servidor RADIUS en xarxes 802.1X, renovacions de clau que alguns clients no gestionen bé, roaming deficient entre punts d’accés, interferències puntuals o punts d’accés que es reinicien per manca de pressupost PoE.
Diagnosi: al controlador o a la plataforma de gestió, revisar els esdeveniments d’associació, desautenticació i fallada d’autenticació dels clients afectats, juntament amb l’uptime dels AP. Si les fallades coincideixen amb l’autenticació, revisar la disponibilitat i els temps de resposta del servidor RADIUS. Les causes de rendiment, que no de tall, es tracten a la nostra guia sobre wifi corporatiu lent.
Sense registres no hi ha diagnosi
Els talls intermitents només es resolen amb dades del moment en què es produeixen. Enviar els registres de firewall, switches i controlador a un servidor syslog centralitzat, sincronitzar l’hora de tots els equips per NTP i monitorar la disponibilitat de manera contínua converteix una incidència irreproduïble en un problema amb una causa identificable.
Quan cal una intervenció especialitzada
Si els talls es repeteixen sense una causa identificada, el primer pas és instrumentar la xarxa. Amb el monitoratge de la xarxa recollim de manera contínua disponibilitat, latència, estat d’interfícies i esdeveniments de tots els equips, cosa que permet correlacionar cada tall amb el seu origen i, en molts casos, anticipar-lo.
Quan la causa és estructural, l’abordem des del disseny: redundància WAN, DNS i DHCP sense punts únics de fallada i protecció de capa 2 a l’arquitectura de xarxa, i un perímetre correctament dimensionat a la seguretat de xarxa.
Per a una primera valoració de l’estat general de la seva infraestructura, pot fer servir el nostre autodiagnòstic de xarxa: dotze controls que revisem en començar qualsevol auditoria.