
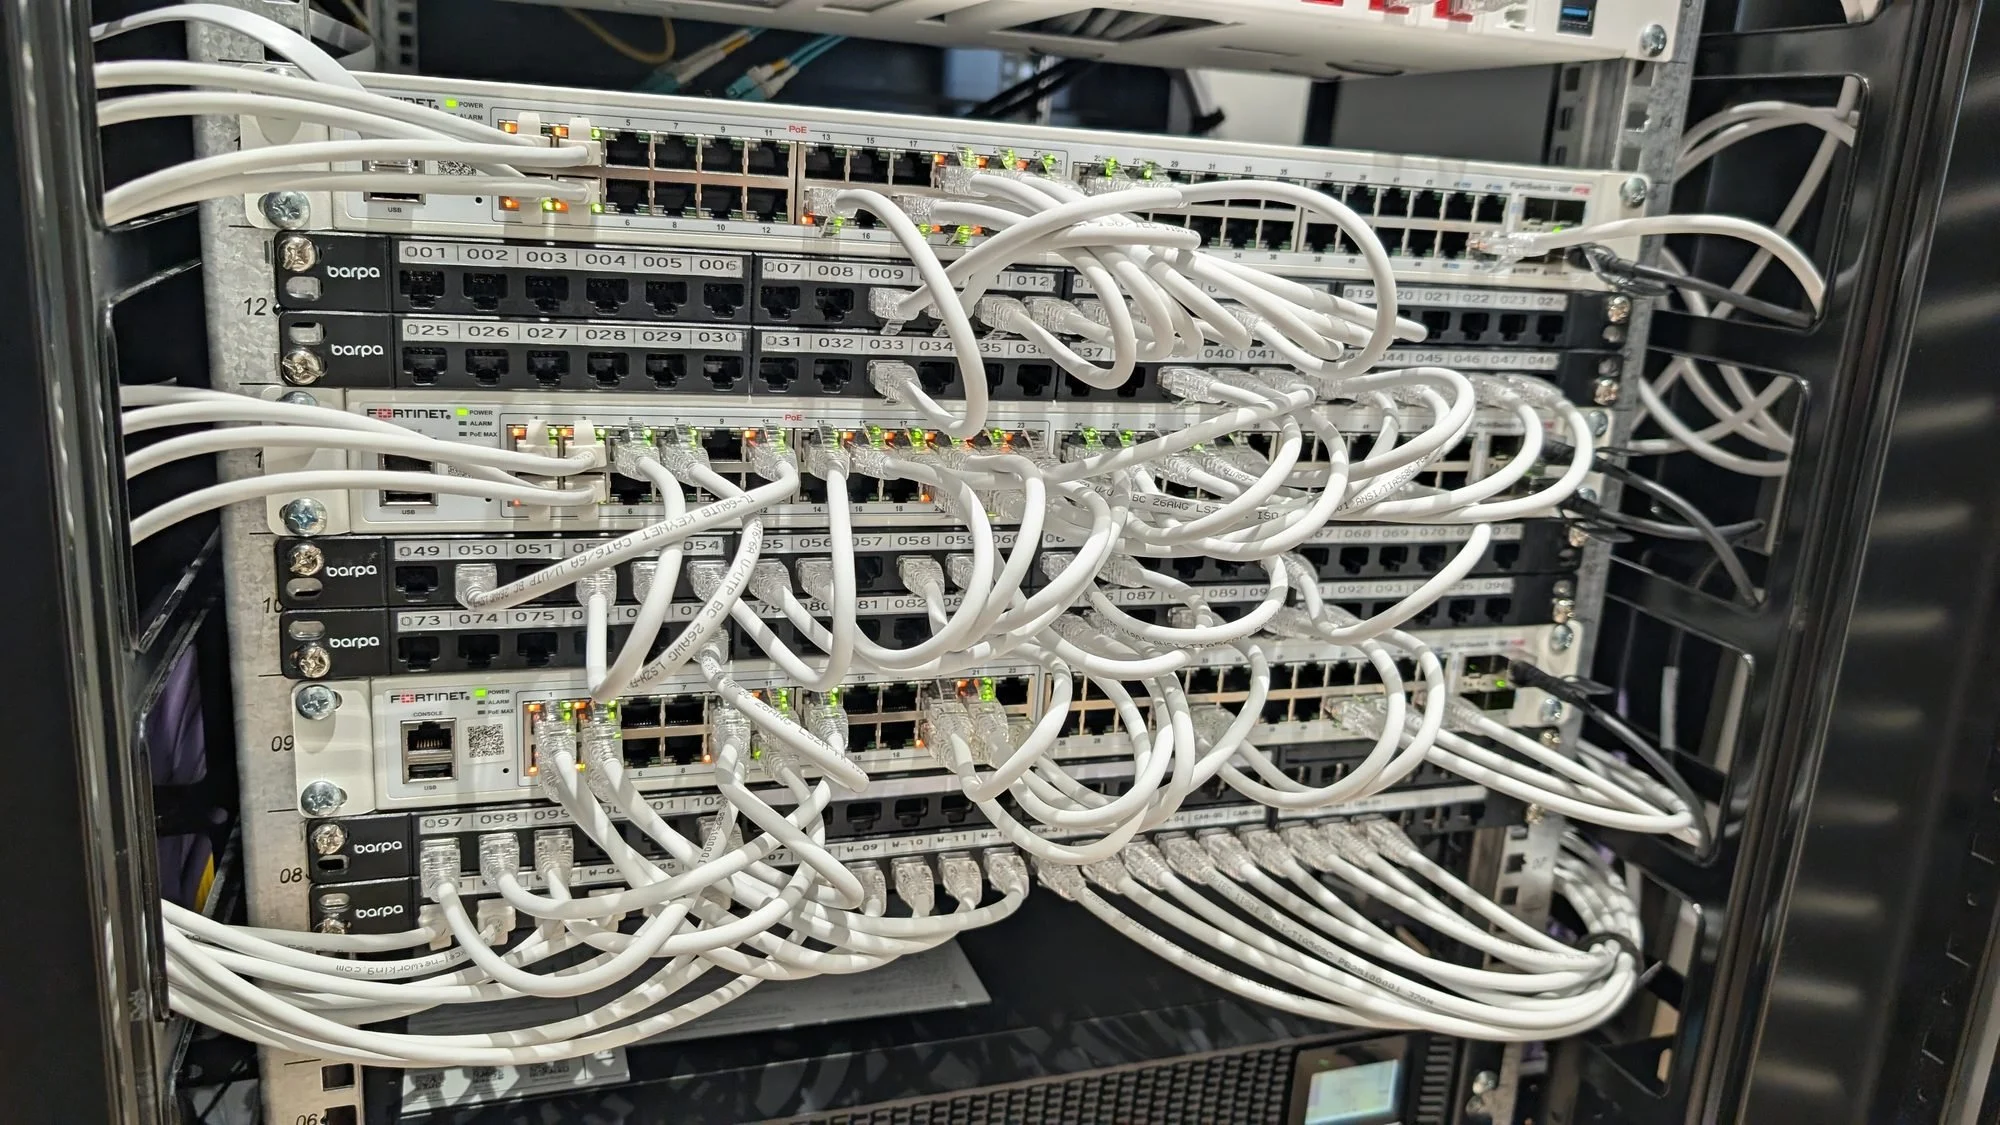
Un corte de conectividad intermitente es una de las incidencias más costosas de resolver en una red empresarial: cuando el técnico llega, el servicio suele haberse restablecido y no queda evidencia de qué ocurrió. El resultado habitual es el reinicio preventivo de equipos o una reclamación al operador, sin haber identificado la causa raíz.
Esta guía describe la metodología que aplicamos para acotar un corte por capas, y las siete causas que encontramos con más frecuencia en infraestructuras de oficina: desde el enlace WAN hasta la alimentación eléctrica del electrónico de red.
Causas analizadas
- Caída o inestabilidad del enlace WAN.
- Fallos de resolución DNS.
- Agotamiento del ámbito DHCP y conflictos de direccionamiento.
- Bucles de capa 2 y tormentas de broadcast.
- Saturación de recursos en el firewall perimetral.
- Microcortes eléctricos y reinicios del electrónico.
- Desconexiones limitadas a la red inalámbrica.
Paso previo: caracterizar el corte
La información más valiosa se obtiene durante el propio corte, no después. Antes de reiniciar ningún equipo conviene responder a cuatro preguntas, que por sí solas descartan la mayoría de hipótesis:
- Alcance: ¿afecta a toda la oficina, a una planta, a un switch concreto o a usuarios aislados? ¿A equipos cableados e inalámbricos por igual?
- Servicios: ¿se pierde solo el acceso a internet o también los recursos internos (servidores de ficheros, impresoras, telefonía IP)?
- Nombre frente a IP: ¿responde un destino externo por dirección IP (por ejemplo, un ping a un resolvedor público) aunque no carguen las webs por nombre?
- Patrón temporal: hora exacta de inicio y fin, duración y si se repite en franjas concretas. Correlacionarlo después con los registros de firewall, switches y controlador es lo que permite cerrar el diagnóstico.
Como regla general: si se pierden también los recursos internos, el problema está en la LAN (causas 3, 4 y 6); si la LAN funciona y falla internet, en la WAN, el DNS o el firewall (causas 1, 2 y 5); si solo afecta a usuarios inalámbricos, en la red wifi (causa 7).
1. Caída o inestabilidad del enlace WAN
Es la causa más evidente, pero no siempre se manifiesta como una caída completa. Los microcortes de pocos segundos, la pérdida de sincronismo en la ONT o el router del operador y los episodios de pérdida de paquetes o latencia elevada en la red del operador provocan desconexiones de VPN, cortes en videoconferencias y sesiones de aplicaciones cloud que se cierran, sin que el enlace llegue a figurar como caído.
Diagnóstico: revisar en el firewall o router el registro de eventos de la interfaz WAN (cambios de estado, renegociaciones, renovaciones de sesión PPPoE o DHCP) y establecer una monitorización ICMP continua tanto contra la puerta de enlace del operador como contra destinos externos. Si la pérdida aparece ya en el primer salto, el problema está en el acceso; si solo aparece más allá, en la red del operador. La mitigación estructural es un segundo enlace de otro operador, con conmutación automática o SD-WAN.
2. Fallos de resolución DNS
Desde el punto de vista del usuario, un fallo de DNS es indistinguible de un corte de internet: nada carga. Las causas típicas son un único servidor DNS interno sin redundancia (con frecuencia el controlador de dominio), reenviadores configurados hacia resolvedores lentos o inestables, o clientes que reciben por DHCP un DNS que ya no existe. En entornos con Active Directory, un fallo de DNS interno afecta además a la autenticación y al acceso a recursos compartidos.
Diagnóstico: durante el incidente, comprobar si hay conectividad por IP y no por nombre. Lanzar consultas con nslookup o dig contra el DNS configurado en el cliente, contra el DNS interno y contra un resolvedor público, comparando resultados y tiempos de respuesta. La configuración correcta incluye al menos dos servidores DNS internos, reenviadores redundantes y un DHCP que entregue ambos.
3. Agotamiento del ámbito DHCP y conflictos de direccionamiento
Cuando el ámbito DHCP se agota, los nuevos dispositivos no obtienen dirección y quedan sin conectividad, mientras el resto de la oficina funciona con normalidad. Es habitual en redes donde invitados, móviles e IoT comparten segmento con los equipos corporativos, con tiempos de concesión largos. Los conflictos de IP, por su parte, aparecen cuando se asignan direcciones estáticas dentro del rango dinámico, y producen cortes intermitentes difíciles de reproducir.
Diagnóstico: un cliente con dirección autoasignada (169.254.x.x) indica que no ha obtenido concesión. Revisar la ocupación del ámbito, el tiempo de concesión y la existencia de estáticos dentro del rango, y consultar en el servidor DHCP o en el switch los registros de conflicto. La solución pasa por segmentar en VLAN con ámbitos dimensionados, separar invitados con concesiones cortas y documentar las reservas.
4. Bucles de capa 2 y tormentas de broadcast
Un latiguillo que conecta dos tomas de la misma red, un switch no gestionado bajo una mesa o un equipo de videoconferencia con dos interfaces puenteadas bastan para crear un bucle. Sin protección, el tráfico de broadcast se multiplica hasta saturar enlaces y CPU de los switches, y la red entera deja de responder de forma intermitente. Es una de las causas que más tiempo cuesta identificar si no se conoce el síntoma.
Diagnóstico: caídas generalizadas de la LAN, actividad continua en todos los puertos y CPU de los switches elevada son indicativos de bucle. Revisar los registros de cambios de topología de spanning tree, los mensajes de MAC flapping y los contadores de broadcast por puerto. La prevención es configuración: RSTP o MSTP correctamente desplegado, BPDU guard en puertos de usuario, storm control y la eliminación de switches no gestionados en el acceso.
5. Saturación de recursos en el firewall perimetral
Un firewall infradimensionado o con todas las funciones de inspección activas puede agotar CPU, memoria o la tabla de sesiones en horas punta. El síntoma es característico: las conexiones ya establecidas siguen funcionando mientras las nuevas fallan o tardan en abrirse, o la latencia aumenta de forma brusca. El crecimiento de plantilla, la adopción de aplicaciones cloud o un equipo infectado generando conexiones masivas pueden desencadenarlo.
Diagnóstico: consultar el histórico de CPU, memoria y número de sesiones concurrentes del firewall y compararlo con las especificaciones del modelo para las funciones de seguridad activas, no con el throughput máximo de catálogo. Identificar los hosts con más sesiones abiertas. Si el equipo opera de forma sostenida cerca de su límite, procede ajustar políticas de inspección o redimensionar.
6. Microcortes eléctricos y reinicios del electrónico
Un microcorte de suministro de una fracción de segundo puede pasar desapercibido para la iluminación y, sin embargo, reiniciar un switch, el firewall o la ONT del operador. El corte resultante dura lo que tarda el equipo en arrancar, varios minutos en muchos casos, y suele atribuirse al operador. Las fuentes de alimentación degradadas y los problemas térmicos en racks sin ventilación producen síntomas equivalentes.
Diagnóstico: comprobar el uptime de cada equipo de red: si alguno se ha reiniciado coincidiendo con el corte, la causa es de alimentación o de hardware, no de red. Revisar los registros de arranque, las alarmas de temperatura y de fuente de alimentación. Todo el electrónico crítico, incluida la ONT del operador, debe estar protegido por un SAI con autonomía conocida y verificada periódicamente.
7. Desconexiones limitadas a la red inalámbrica
Si los equipos cableados mantienen la conectividad y solo los inalámbricos la pierden, el dominio del problema es la red wifi. Las causas habituales son fallos de autenticación contra el servidor RADIUS en redes 802.1X, renovaciones de clave que algunos clientes no gestionan bien, roaming deficiente entre puntos de acceso, interferencias puntuales o puntos de acceso que se reinician por falta de presupuesto PoE.
Diagnóstico: en el controlador o plataforma de gestión, revisar los eventos de asociación, desautenticación y fallo de autenticación de los clientes afectados, junto con el uptime de los AP. Si los fallos coinciden con la autenticación, revisar la disponibilidad y los tiempos de respuesta del servidor RADIUS. Las causas de rendimiento, que no de corte, se tratan en nuestra guía sobre wifi corporativo lento.
Sin registros no hay diagnóstico
Los cortes intermitentes solo se resuelven con datos del momento en que ocurren. Enviar los registros de firewall, switches y controlador a un servidor syslog centralizado, sincronizar la hora de todos los equipos por NTP y monitorizar la disponibilidad de forma continua convierte una incidencia irreproducible en un problema con causa identificable.
Cuándo es necesaria una intervención especializada
Si los cortes se repiten sin causa identificada, el primer paso es instrumentar la red. Con la monitorización de la red recogemos de forma continua disponibilidad, latencia, estado de interfaces y eventos de todos los equipos, lo que permite correlacionar cada corte con su origen y, en muchos casos, anticiparlo.
Cuando la causa es estructural, la abordamos desde el diseño: redundancia WAN, DNS y DHCP sin puntos únicos de fallo y protección de capa 2 en la arquitectura de red, y un perímetro correctamente dimensionado en la seguridad de red.
Para una primera valoración del estado general de su infraestructura, puede utilizar nuestro autodiagnóstico de red: doce controles que revisamos al iniciar cualquier auditoría.